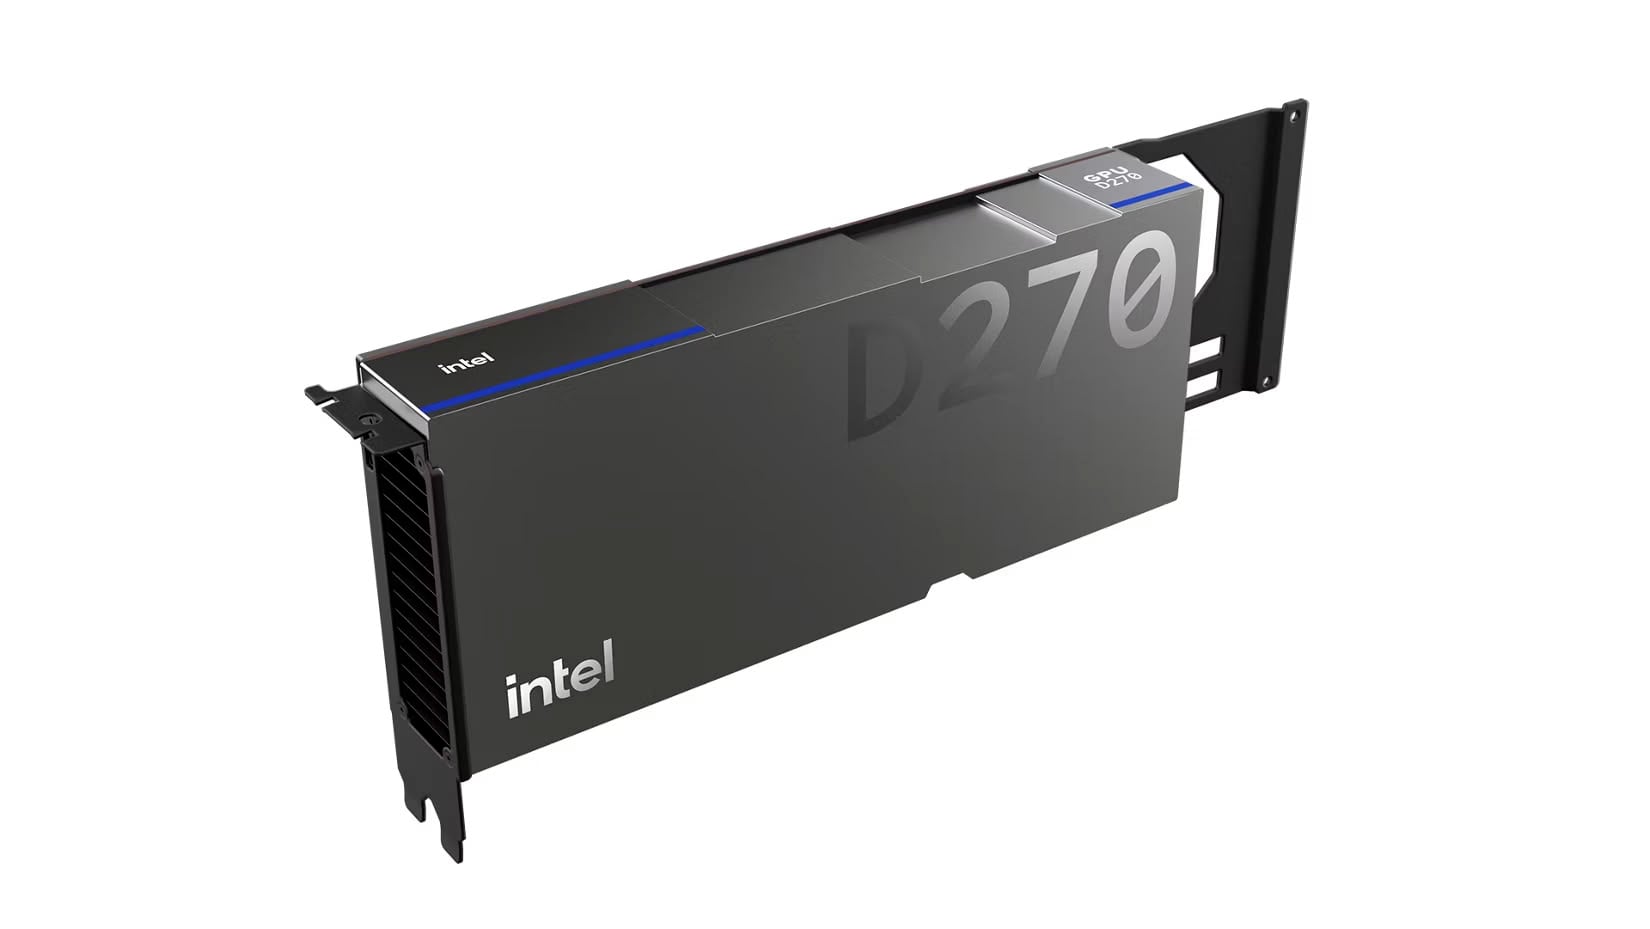




Intel hat vor Kurzem seine neueste KI-Beschleuniger-Reihe enthüllt, die den Namen GPU D-Series trägt; ihre Mitglieder tragen den Codenamen Crescent Islands.
Die Basis der neuen KI-Beschleuniger bildet eine GPU mit 32 Xe3P-Kernen, die außerdem 256 XMX-Engines und 32 MB einheitlichen L2-Cache erhalten hat. Wie breit das Speicherinterface genau ausfallen wird, ist nicht bekannt, doch bis zu 480 GB LPDDR5X-Speicher können an die GPU angebunden werden. Das Basismodell von Intel selbst kommt zwar „nur“ mit 160 GB Speicher, doch das Intel-Team ermöglicht es den AIB-Partnern, Modelle mit bis zu 480 GB zu bauen. Sogar laut einem Leaker könnten einige Partner später noch Versionen mit 512 GB vorstellen, was bislang jedoch offiziell keine Seite bestätigt hat. Die Speicherbandbreite dürfte 1,5 TB/s betragen, die GPU leidet in dieser Hinsicht also keinen Mangel.
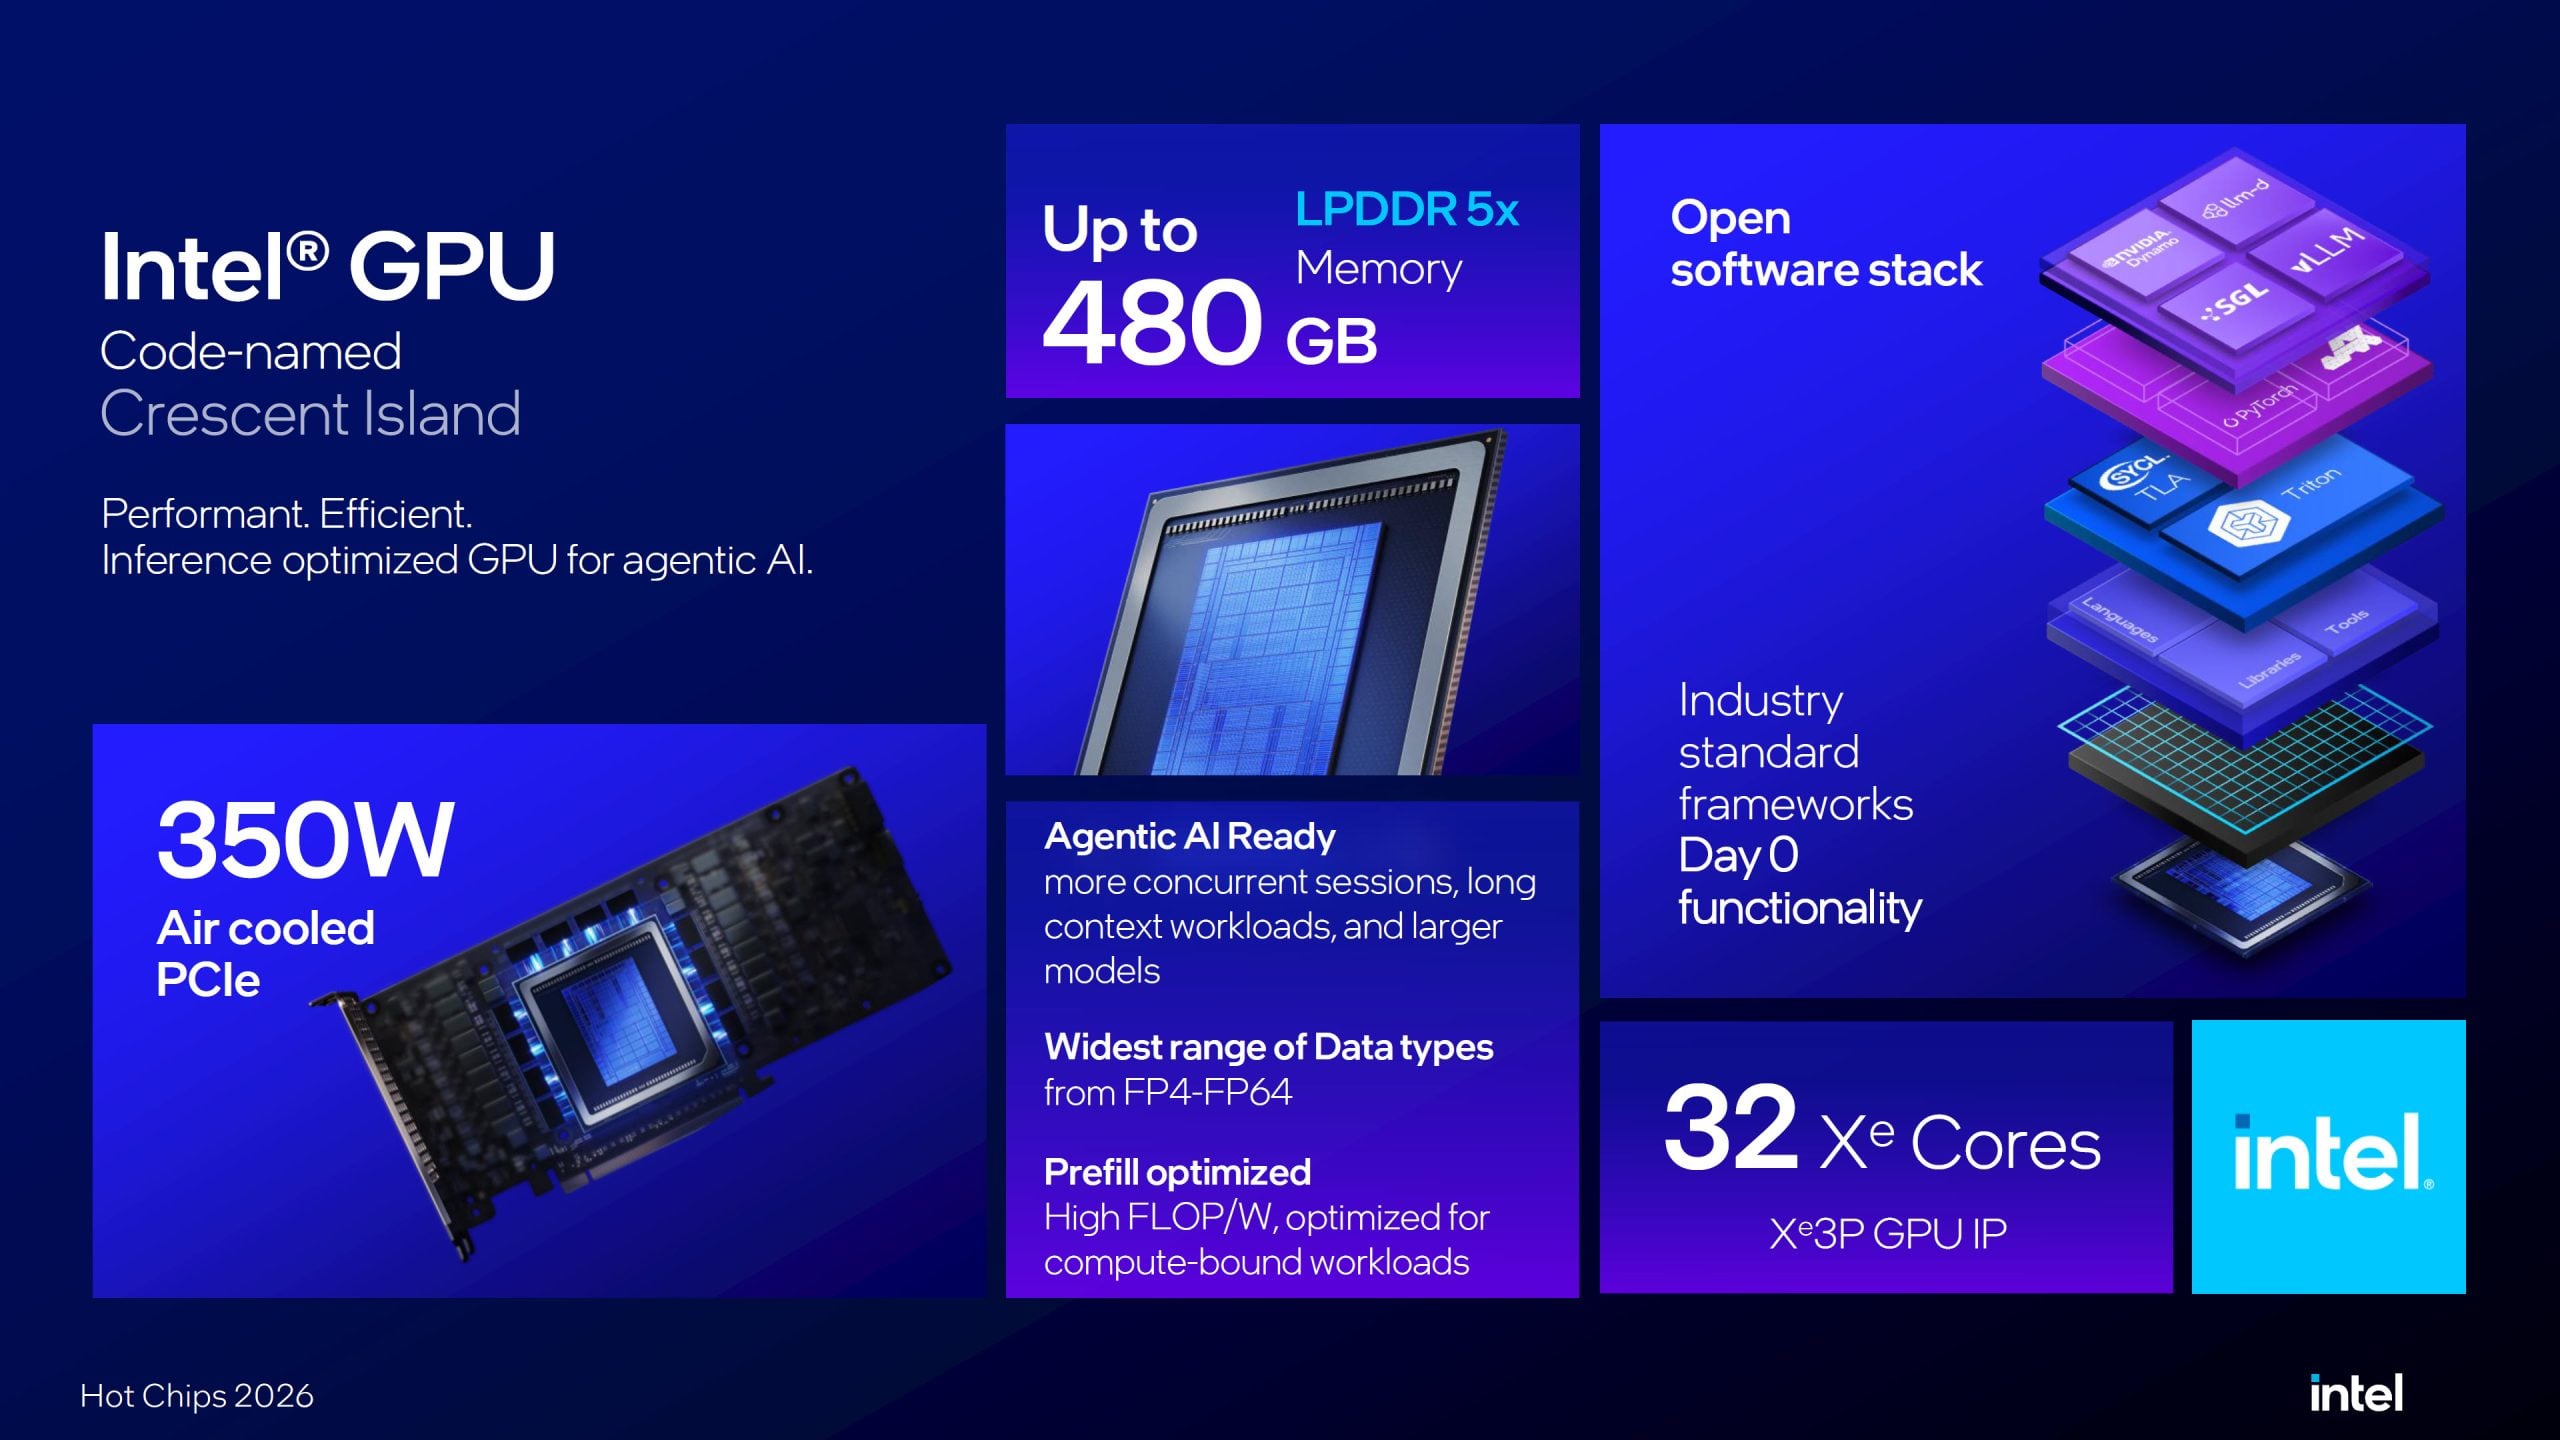
Die GPU selbst kann bei FP8-Aufgaben eine maximale Rechenleistung von 1,3 PetaFLOP/s erreichen, und die unterstützten Datenformate reichen deutlich weiter, von FP4 bis hin zu FP64, sodass sich das Produkt für viele verschiedene Aufgaben eignet. Die GPU hat zudem eine leistungsfähige Media-Engine erhalten, die um vier Encoder- und vier Decoder-Einheiten aufgebaut ist und die Schlagkraft des Systems weiter erhöht.
Interessant ist, dass die XMX-Engines überarbeitet wurden: Im Vergleich zu den Xe3-basierten Lösungen steht nun statt 4 eine Datenverarbeitungsstruktur mit 16 Stufen Tiefe zur Verfügung, wodurch sich eine höhere Datendichte verarbeiten lässt, was sich günstig auf den Ablauf der verschiedenen Aufgaben und auf die Leistung selbst auswirkt. Dank der tieferen systolischen Arrays haben einzelne Teile der Pipeline einen einfacheren Aufbau, was höhere Taktraten begünstigt und zugleich eine höhere Energieeffizienz ermöglicht.
Das neue Design passt hervorragend zu den Besonderheiten verschiedener KI-Aufgaben, etwa zum Betrieb moderner großer Sprachmodelle (LLMs). Auch die Registerfiles wurden vergrößert und bieten nun 1 MB Kapazität pro Kern, während der L1-Cache pro Kern 512 KB groß ist. Insgesamt besteht das Design aus 256 XMX-Engines und 256 Vektor-Engines, von denen auf jeden Xe3P-Kern jeweils acht entfallen. Die Xe3P-Architektur wurde ausschließlich zur Beschleunigung von KI-Aufgaben entwickelt und enthält dementsprechend keine Grafikverarbeitungseinheit. Nach Intels Plänen kann ein solcher KI-Beschleuniger ein großes Sprachmodell mit bis zu 300 Milliarden Parametern ausführen, und bei einem System mit acht Karten ist auch der Betrieb von LLMs mit einer Billion Parametern kein Problem.
Bei der GPU D-Series gilt eine TDP von 350 W, das Produkt nutzt eine PCI-Express-5.0-x16-Schnittstelle und Luftkühlung. Gemeint ist dabei allerdings keine eigene Lüfterkühlung, sondern die im jeweiligen Server verbauten Systemlüfter, die frische Luft durch die Lamellen des Kühlkörpers blasen. Muster der neuen KI-Beschleuniger werden bereits an die Partner ausgeliefert, wann die Produkte jedoch in breiterem Umfang erhältlich sein werden, ist bislang nicht bekannt, und auch zur Preisgestaltung äußerte man sich zumindest vorerst nicht.