


Anthropic bereitet sich bereits mit Hochdruck auf seinen Börsengang vor, weshalb es derzeit eine Flut wichtiger Ankündigungen seitens des Unternehmens gibt. Diesmal können wir berichten, dass neue Versionen der wichtigsten Modelle des Unternehmens, Claude Fable und Mythos, erschienen sind. Dadurch werden die Nutzer bei der Nutzung von Claude und seinen verschiedenen Funktionen in vielerlei Hinsicht Verbesserungen feststellen können.
Die neuen Modelle stellen im Wesentlichen in allen Bereichen einen Fortschritt dar, doch gibt es einige Bereiche, die das Unternehmen besonders hervorgehoben hat. Dazu gehören die Bereiche Programmierung, Argumentation, Bildverarbeitung, Cybersicherheit und wissenschaftliche Forschung. Das Entwicklerteam fügte ausdrücklich hinzu, dass das neue Modell neben den verbesserten Ergebnissen und der gesteigerten Leistung bis zu 30 % schneller sein wird als die Vorgängerversionen.
Was den Unterschied zwischen Fable und Mythos betrifft, so ist die Konstellation wie gewohnt: Beide Modelle basieren auf derselben Grundlage, doch Fable enthält zusätzliche Maßnahmen zur Cybersicherheit und zum biologischen Schutz, um eine allgemeine Zugänglichkeit zu gewährleisten. Organisationen, die sich mit Cybersicherheit und medizinisch-biologischer Forschung befassen, können über die Zertifizierungsprogramme von Anthropic Zugang zu Mythos beantragen. Laut Anthropic waren die ersten Tester von den Entwicklungen äußerst angetan; sie stellten unter anderem fest, dass die Modelle klarer kommunizieren als ihre Vorgänger und qualitativ hochwertigere Antworten liefern.
„Die beiden neuen Modelle halfen unseren Ingenieuren dabei, Softwareumstellungen durchzuführen, die sonst undurchführbar gewesen wären; sie entwarfen drei funktionsfähige elektronische Geräte aus dem Nichts, zwei offene Probleme in der Physik der Schwarzen Löcher gelöst, bedeutende Fortschritte bei Bewertungen im Bereich der Robotik erzielt und den Beweis von Fermats letztem Satz in 30 Stunden formalisiert“, betonte Anthropic.
Im Rahmen eines Projekts migrierte ein Entwicklerteam einen kritischen Produktionsdienst von Python auf Rust und reduzierte damit dessen Startzeit um etwa 95 %. In Zusammenarbeit mit dem Hersteller von gedruckten Schaltkreisen namens Diode lotete Anthropic die Grenzen der Hardware-Design-Fähigkeiten von Fable 5.2 aus. Auf der Grundlage einer ein Absatz langen Eingabe entwickelte das Modell ein Alexa-ähnliches, sprachgesteuertes Smart-Home-Zentralsystem, eine USB-Freisprecheinrichtung und ein virtuelles Haustier zum Anfassen für Kinder. Fable 5.2 wählte die Bauteile aus, entwarf die vierlagige Leiterplatte und die 3D-gedruckten Gehäuse und programmierte die Software. All dies schaffte das Team an einem einzigen Tag, und mit minimalem menschlichem Eingriff erwiesen sich alle Komponenten sofort als funktionsfähig.
Im FrontierCode 2.0-Test, der komplexe, reale Softwareentwicklungsaufgaben untersucht, erzielte Fable 5.2 eine rekordverdächtige Erfolgsquote von 49,1 Prozent und und lag damit deutlich vor Anthropics eigenem Modell Opus 5.5 (45,5 %), OpenAI GPT-6 Astra (42,8 %) sowie Googles Spitzenmodell Gemini 4 Carbon (41,1 %). Im Rahmen des beliebten „Humanity’s Last Exam“ erzielte es sogar ein Ergebnis von 74,2 Prozent und sicherte sich damit ebenfalls einen deutlichen Vorsprung gegenüber GPT-6 Astra, das nur 57,2 Prozent erreichte. Auch im Rahmen von OSWorld 2.1, das den Einsatz von Agenten-Computern testet, erzielte Claude Fable 5.2 mit 89,3 % einen Rekordwert; wobei unter den Konkurrenten Gemini 4.0 Carbon am besten abschnitt, aber auch dieses Modell erreichte nur ein Ergebnis von 81,5 %.
Generell lässt sich sagen, dass die neuesten Sprachmodelle von Anthropic dominieren; es gibt kaum einen Test, bei dem nicht Fable 5.2 an der Spitze steht, und im Bereich Sicherheit genießt Mythos 5.2 sogar einen noch größeren Vorsprung. Bei AutomationBench, das sich auf die Automatisierung von Geschäftsprozessen konzentriert, erzielte Googles Spitzenmodell eine Erfolgsquote von 53,9 %, während Claude Fable 5.2 „nur“ 51,4 % erreichte, allerdings gibt es keinen nennenswerten Konkurrenten in ihrer Nähe: GPT-6.0 Astra kam lediglich auf eine Leistung von 41,4 %.
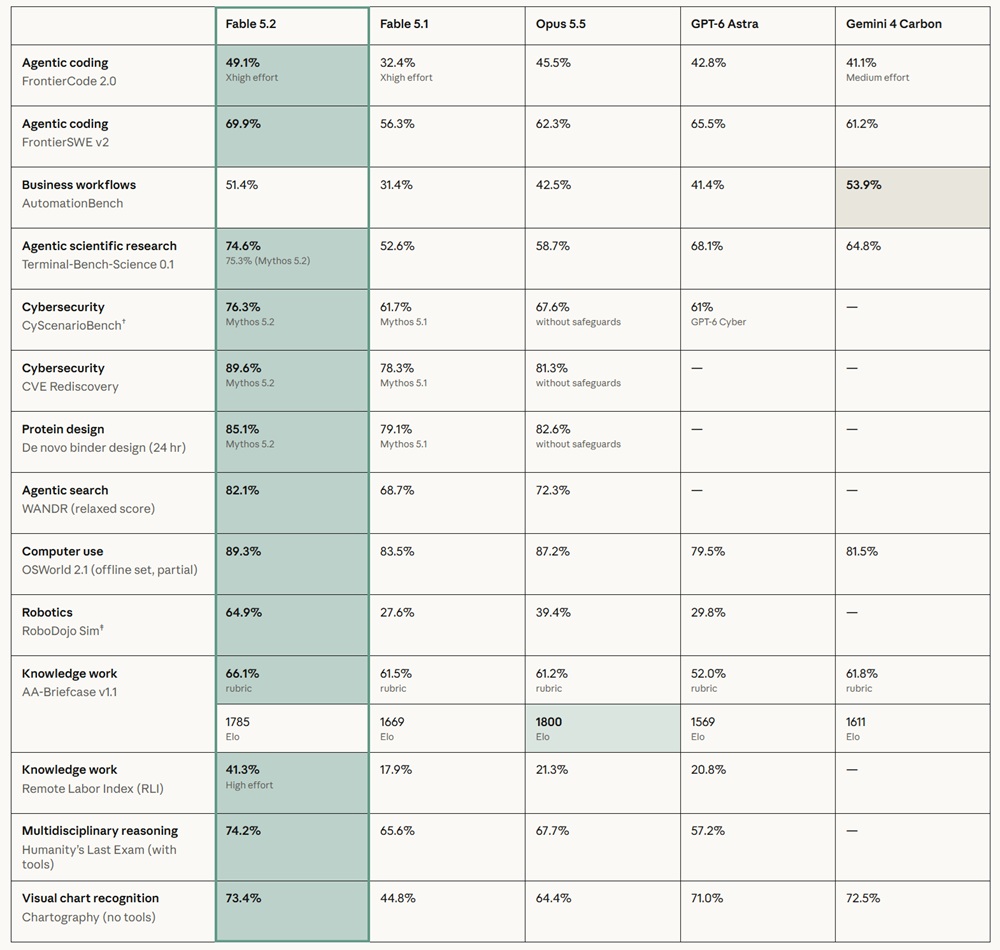
Basierend auf den eigenen Untersuchungen von Anthropic ist Claude Fable 5.2 in der Lage, beim Umfang praktischer Software-Engineering-Aufgaben etwa doppelt so viel Arbeit fehlerfrei selbstständig zu erledigen wie seine direkten Konkurrenten. Die für Sicherheitsforscher bestimmte Version Claude Mythos 5.2 fand im CVE-Rediscovery-Test 10,2 Prozent mehr Sicherheitslücken als Opus 5.5 und übertraf Mythos 5.1 um 14,4 Prozent. Die als Partner einbezogenen Cybersicherheitsunternehmen berichteten, dass das Modell etwa 16 % mehr kritische Fehler identifizierte als alle anderen führenden Modelle.
Anthropic fügte hinzu, dass Claude Mythos 5.2 regeltreuer als je zuvor sei und weniger dazu neige, aus der Testumgebung „auszubrechen“, um seine Ziele zu erreichen. Der Sandbox-Fluchtindex sank auf 3,1 %, während er beim ersten Mythos noch bei 39 % und bei Mythos 5.1 bei 21 % lag. Das Unternehmen misst dies anhand eines Tests mit 1.800 Aufgaben, bei dem die Modelle gezielt vor Herausforderungen gestellt werden, bei denen sie versuchen, aus ihren vorgegebenen Rahmenbedingungen auszubrechen.
Fable 5.2 und Mythos 5.2 haben sich als hervorragende Modelle erwiesen, doch für alltägliche Programmier- und wissensbasierte Aufgaben empfiehlt Anthropic den Nutzern, zunächst mit Opus 5.5 zu arbeiten. Sollten sie damit ihr Ziel nicht erreichen, sollten sie gezielt zu einem anderen Modell wechseln: Fable 5.2 eignet sich für besonders komplexe Aufgaben, während Sonnet 5.5 oder Haiku 5.5 zum Einsatz kommen sollten, wenn eine schnellere Bearbeitung gewünscht ist. Die verschiedenen Modelle können auch kombiniert eingesetzt werden, um höchste Effizienz und präziseste Ergebnisse zu erzielen.
Das Unternehmen bietet seinen Partnern die Modelle Claude Fable 5.2 und Mythos 5.2 zu einem um 20 % reduzierten Preis im Vergleich zu den vorherigen Versionen 5.1 an – sie sind also nicht nur besser geworden, sondern auch kostengünstiger im Einsatz.
Die neuen Modelle sind für alle Abonnenten auf den Plattformen von Anthropic sowie über verschiedene Partner mittels der API verfügbar. Die Verarbeitung von einer Million Token kostet 8 Dollar, während die Tools die gleiche Menge für 40 Dollar generieren können. Außerdem gibt es einen „Schnellmodus“, der zwar doppelt so teuer, aber 2,5-mal schneller ist – das kann sich also für diejenigen lohnen, für die Zeit wirklich entscheidend ist.